Revolut corta 90% dos custos de IA trocando Claude por modelo chinês local
Publicado em
Semana passada saiu uma notícia BEM relevante pra empresas grandes. O @Revolut, banco digital do Reino Unido, disse que trocou o Claude por um modelo chinês rodando localmente e, com isso, está economizando 90% dos custos.
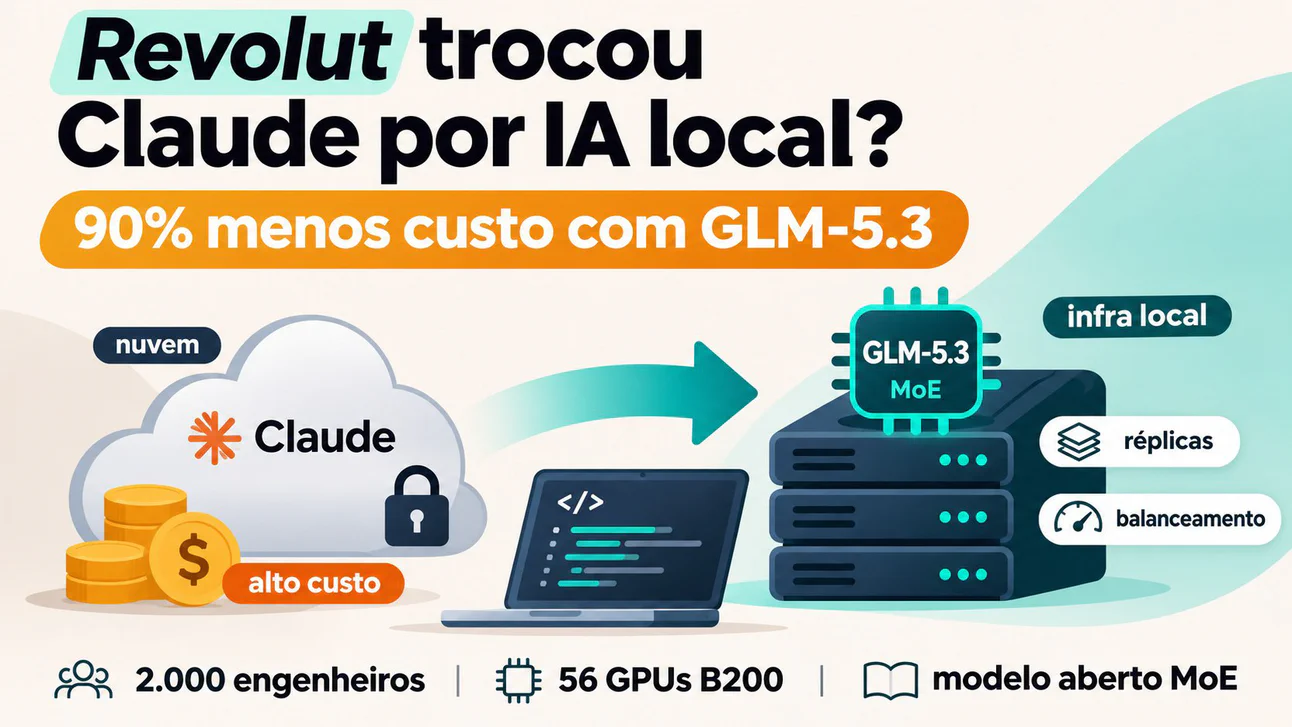
O David Abitbol, líder de infra da empresa, disse que tinha engenheiro gastando entre 1.000 e 10.000 dólares por mês em ferramentas de código com IA, sem ROI que justificasse. E que essa troca estaria valendo muito a pena.
Minha primeira reação foi: duvido. Aí, fui atrás de ver as afirmações deles: que estavam rodando pra 2000 engenheiros, com uma latência de 200 tokens/segundo e rodando em 8 máquinas NVIDIA DGX B200 (total de 56 GPUs B200). Minha segunda reação: DUVIDO que rode nessa latência com esse cluster.
Mas depois de dar uma estudada mais a fundo, deu pra ver que realmente é possível, com alguns asteriscos.
O modelo que eles estão rodando localmente é o GLM-5.3, que tem 753B parâmetros (isso é muito) e é realmente excelente pra código. A grande sacada é que, como quase todos os modelos top de hoje em dia, ele é um MoE (Mixture-of-Experts). Isso significa que apesar de a rede neural inteira (todos os 753B parâmetros) ter que estar carregada na memória, pra gerar respostas, ele ativa apenas 40B. Acredito ainda que estejam usando uma versão quantizada do modelo, o que também otimiza a velocidade e perde quase nada de qualidade (tenho um artigo sobre quantização no meu blog, que deixo no primeiro comentário abaixo).
Outra sacada deles foi de não subir apenas um GLM-5.3, mas várias réplicas dele, e fazer um balanceamento de carga bem feito. Assim, um engenheiro não tem que ficar esperando que aquele modelo único termine a resposta de outro.
E o que fecha a história é que eles não trocaram TUDO por essa solução interna. Disseram que, pra problemas complexos, os engenheiros ainda têm acesso ao Claude Code e ao Codex, mas que o GLM-5.3 vira o faz-tudo pras tarefas de programação do dia a dia. E realmente, qualquer modelo desse calibre (GLM, Kimi, DeepSeek, Muse) já é bom o bastante pra fazer CRUD e essas coisas que são 90% do que um dev faz semanalmente.
Como resultados, eles reportaram uma melhora de 60% no tempo de codificação e 70% no lead time (vale o adendo honesto de que esses números são autodeclarados, e parte do ganho pode vir simplesmente de tirar o limite de uso dos modelos privados, não do modelo em si).
Vale um grande asterisco final aqui: cada uma das máquinas DGX B200 que eles usaram (e eles têm 8) custa entre 600 e 900 mil dólares. Ou seja, empresa pequena ou média não vai conseguir replicar isso em escala ou latência. Essa conta só fecha pra quem já tem volume (e caixa) pra isso.
De qualquer forma, é um sinal importante que modelos abertos como o GLM-5.3 já chegaram num nível competitivo o bastante pra justificar esse tipo de aposta em produção, numa fintech gigante processando código sensível todo dia.