Marca d’água invisível no Claude
Publicado em
A partir de 2 de agosto de 2026, a Anthropic passou a inserir uma marca d’água invisível em todo e qualquer texto gerado pelo Claude, que consegue indicar estatisticamente que ele foi gerado por IA.
Diferentemente do que muita gente pode pensar inicialmente, isso não tem nada a ver com caracteres invisíveis ou em metadados (que poderiam ser facilmente eliminados), mas é algo embutido na escolha das próprias palavras. Isso vai ser válido pra todos os textos gerados por modelos Claude lançados a partir dessa data.
Vou te explicar exatamente o que mudou, por que mudou e (a parte mais gostosa) como essa marca d’água funciona por dentro, pra quem quiser se aprofundar.
Bora lá?
Por que a Anthropic resolveu fazer isso agora
A resposta curta é: o AI Act da União Europeia. Mais especificamente, o Artigo 50(2) dele, que trata de transparência de conteúdo gerado por IA. Em julho de 2026, a Anthropic assinou, junto com cerca de 190 signatários (outras empresas de IA incluídas), o Código de Prática sobre Transparência de Conteúdo Gerado por IA da UE. Esse código obriga provedores de sistemas de IA a “marcarem” de alguma forma o conteúdo gerado por seus modelos, pra que outros sistemas consigam identificar essa origem.
A regra da UE entrou em vigor em 2 de agosto de 2026, e é exatamente essa a data de corte que a Anthropic usou: todo modelo Claude lançado a partir daquele dia já embute a marca d’água por padrão, sem opção de desligar. Modelos mais antigos (os que já estavam no mercado antes disso) vão ganhar a mesma capacidade aos poucos, com prazo até 2 de dezembro de 2026 pra ficarem regularizados.
Segundo a própria Anthropic, imagens, arquivos SVG, PNG e outros formatos de mídia gerados pelo Claude também vão ter o que eles chamam de “metadados de proveniência assinados”, seguindo o padrão C2PA (aquele mesmo usado por outras empresas de tecnologia pra sinalizar conteúdo sintético). A diferença é que, no caso de arquivos, dá pra visualizar esse metadado se você souber onde procurar. Já no texto, a marca é completamente invisível a olho nu.
Como ainda não existe uma forma confiável de aplicar essa regra só pra usuários europeus, eles decidiram simplesmente ligar a watermark pra todo mundo, em qualquer lugar do planeta. Ou seja, se você usa o Claude no Brasil, sua resposta também está marcada.
O que exatamente é uma marca d’água de texto
Esse conceito de watermarking (marca d’água) de texto gerado por IA é uma técnica que altera sutilmente as escolhas de palavras de um modelo de linguagem, de um jeito que não muda o sentido do texto, mas cria um padrão estatístico detectável por quem tem a “chave” certa.
Pra entender isso, vale relembrar rapidinho como um LLM escreve um texto. Ele não pensa a frase inteira de uma vez.
Primeiro, o modelo recebe tudo que já foi escrito antes (o contexto) e, com base nisso, vai querer prever o próximo token (sub-palavra) com a maior probabilidade pra continuar esse texto. Ele calcula um monte de tokens candidatos, e cada um recebe uma probabilidade de ser o próximo. O modelo escolhe um deles, normalmente o mais provável, e este token é adicionado ao texto. O processo se repete, token por token, até a resposta terminar.
Pensando num exemplo prático:
O tempo hoje está muito frio e…
O próximo token quase certamente vai ser algo como “nublado”, “cinzento” ou “úmido”. Dificilmente vai ser “Gretchen” ou “NVIDIA”, porque esses tokens têm probabilidade pertinho de zero ali. É basicamente um jogo de qual é a próxima palavra mais provável, repetido centenas de vezes até a resposta terminar.
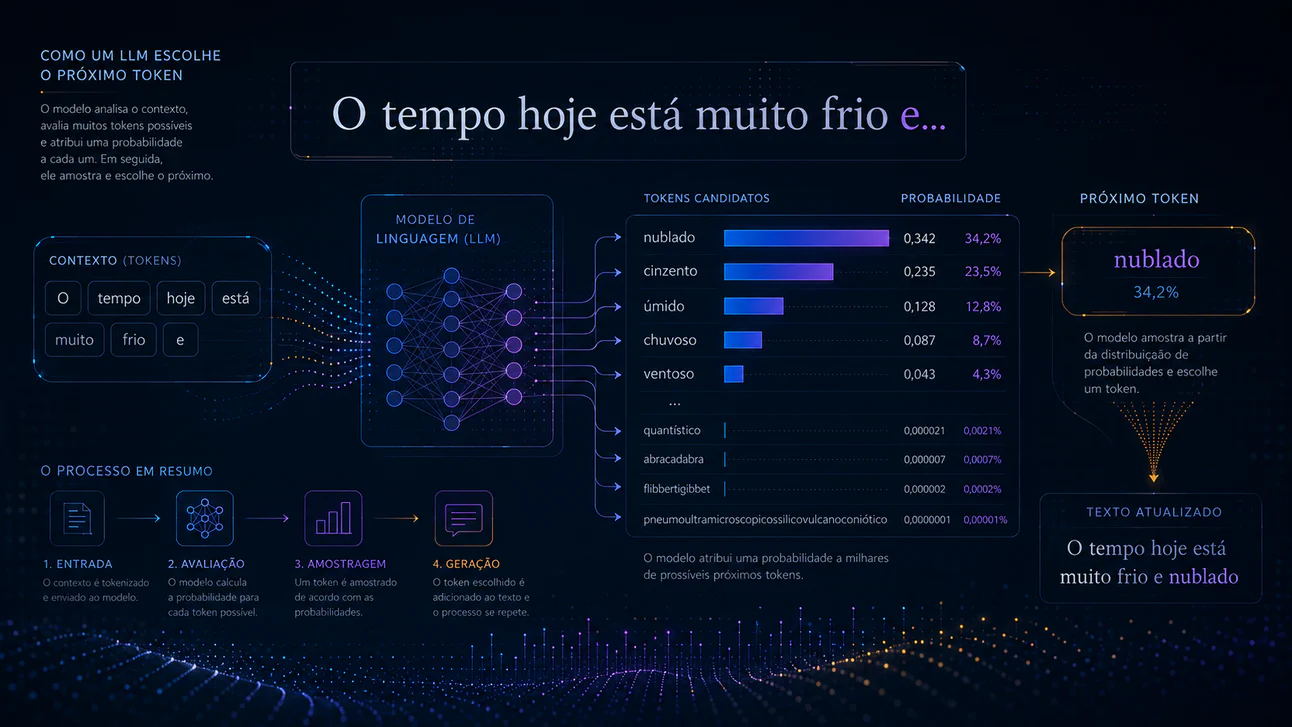
Só que, na imensa maioria das vezes, não existe uma única palavra certa. Existem várias palavras “empatadas” ou bem próximas em probabilidade. Se a gente está num contexto de clima ruim, o modelo dizer que “Ontem choveu muito”, “Ontem choveu bastante” ou “Ontem choveu significativamente”, meio que dá na mesma e são escolhas perfeitamente razoáveis. É exatamente nesse empate técnico que a marca d’água entra em ação.
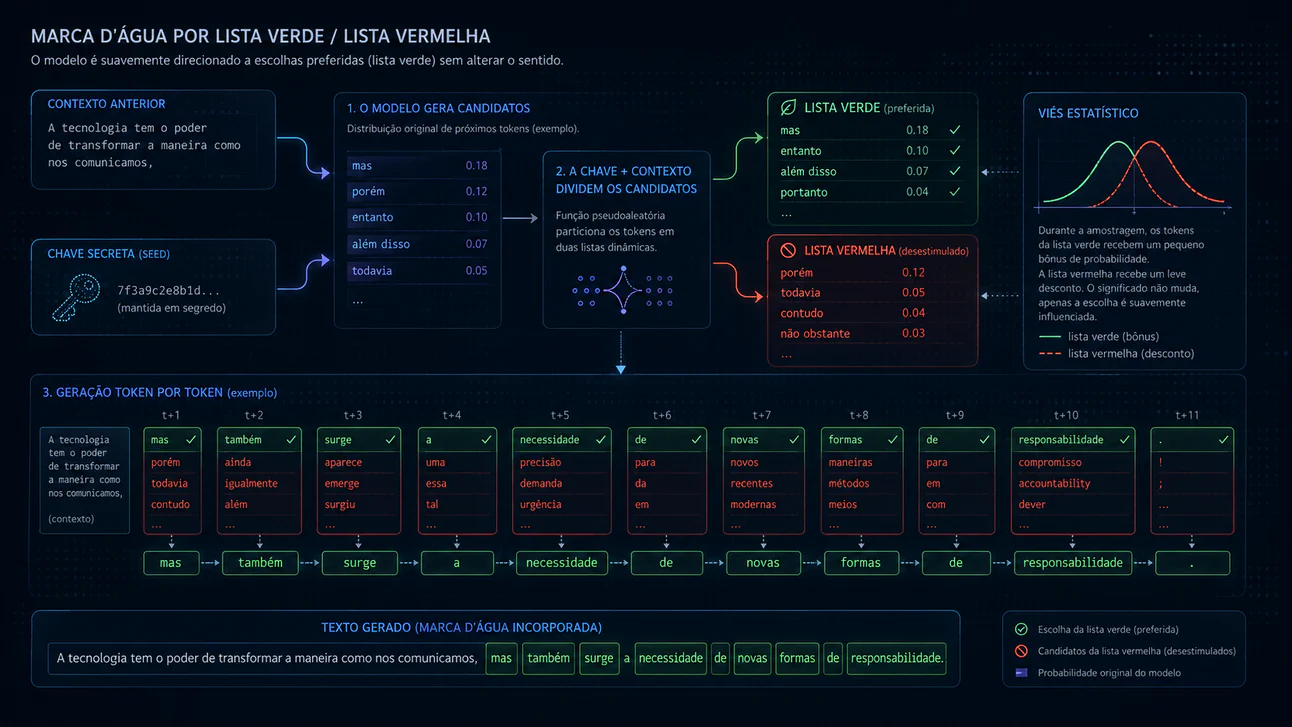
Em vez de sortear a próxima palavra usando um gerador de números aleatórios comum (como o modelo normalmente faria pra dar aquela variação natural nas respostas), o sistema usa uma chave secreta combinada com as palavras que vieram antes pra decidir, de forma pseudoaleatória mas reprodutível, qual das opções “empatadas” vai ser escolhida.
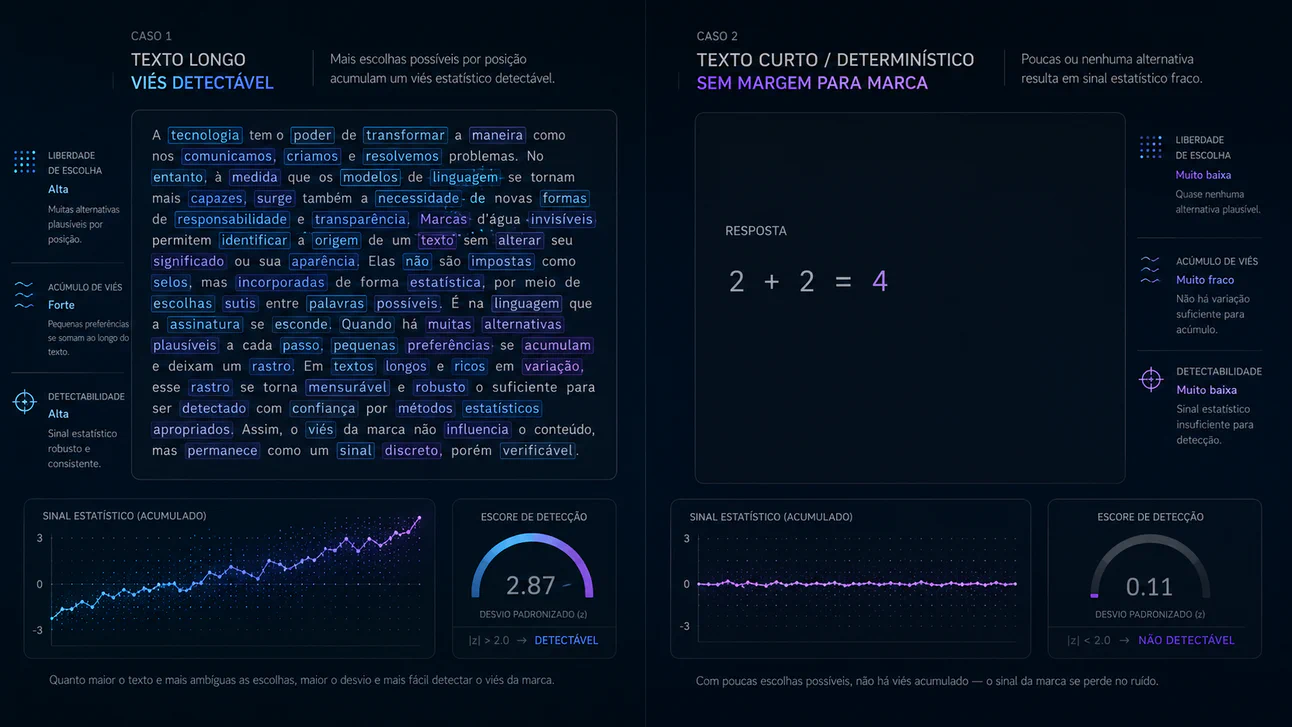
Isso aplicado só algumas poucas vezes não faz diferença, assim como quando você joga uma moeda pra cima, é bastante possível que você tire 4 caras e apenas 1 coroa. Porém, quanto mais você joga isso pra cima, o resultado vai ficar mais e mais próximo de 50% cara e 50% coroa (a não ser que seja uma moeda viciada). A mesma lógica se aplica ao texto gerado pelo Claude: pra apenas uma frase, é praticamente impossível dizer se ele está viciado (ou seja, se foi gerado por IA ou não), mas isso ao longo de texto inteiro mais longo, começa a aparecer um padrão de escolhas que parece aleatório pra um leitor comum, mas que é, na real, uma sequência “viciada”, determinada por aquela chave, e quem tem a chave consegue rodar a conta de trás pra frente e analisar se aqueles tokens/palavras escolhidos estão mais próximo do 50-50%, ou mais próximo de algo como 65-35%. A “aleatoriedade” continua parecendo aleatória, só que ela tem uma origem controlada.
A pesquisa por trás: o método da “lista verde” de Kirchenbauer
Essa ideia não nasceu com a Anthropic. Ela vem sendo desenvolvida pela academia há alguns anos, e um dos trabalhos mais citados (e provavelmente o pontapé inicial dessa onda toda) é o paper A Watermark for Large Language Models, de John Kirchenbauer e colegas, lançado em 2023.
A ideia central desse paper é simples de explicar com uma analogia. Imagine que, antes de o modelo escolher a próxima palavra, uma “chave” (derivada da palavra anterior) divide todo o vocabulário em dois grupos, uma lista verde (com tokens como “bastante” e “significativamente”) e uma lista vermelha (com tokens como “muito” e “abundantemente”). O modelo então recebe um empurrãozinho estatístico pra preferir palavras da lista verde, sempre que isso não prejudicar demais a qualidade do texto. Como esse processo se repete a cada palavra, e a divisão entre lista verde e vermelha muda dinamicamente token a token (baseada no contexto anterior). O resultado é um texto que, sem essa marca, teria uma distribuição normal de palavras da lista verde e vermelha, mas que, com a marca, tem uma proporção estatisticamente maior de palavras “verdes”.
Pra detectar se um texto foi gerado com aquela marca, basta rodar o mesmo algoritmo de divisão verde/vermelha sobre o texto suspeito e contar quantas palavras caíram na lista verde. Se a proporção for muito maior do que o esperado pelo puro acaso, é sinal forte de que aquele texto saiu de um modelo com aquela watermark ativada.
SynthID-Text: o método que a Anthropic diz usar como base
Agora, a peça mais interessante do quebra-cabeça: segundo a própria Anthropic, a implementação deles é baseada na abordagem SynthID-Text, criada pelo Google DeepMind e publicada na revista Nature em 2024. Esse método já é usado desde 2023 pra marcar textos gerados pelo Gemini, e funciona com uma lógica parecida com a de Kirchenbauer, mas mais refinada.
Em vez de simplesmente dividir o vocabulário em duas listas fixas, o SynthID-Text usa o que os pesquisadores chamam de “funções de pontuação aleatória” (random scoring functions), amarradas a uma chave criptográfica e ao contexto de tokens anteriores. Na prática, ele modifica o próprio processo de amostragem do próximo token: em vez de sortear aleatoriamente entre as opções mais prováveis (como o modelo faria numa geração comum), ele usa uma fonte de aleatoriedade derivada da chave secreta. O resultado final tem qualidade de texto praticamente idêntica ao texto sem marca (esse é, aliás, um dos grandes méritos do método), mas carrega uma assinatura estatística sutil espalhada ao longo de toda a resposta.
A vantagem dessas técnicas é que não tem nenhum caractere escondido, nenhuma tag oculta ou nada que possa ser facilmente removido. É a própria escolha estatística de palavras que carrega a informação. Isso também explica por que a marca sobrevive a coisas como copiar e colar o texto em outro programa, ou até fazer pequenas edições nele. Como a marca está distribuída ao longo de centenas de escolhas de palavras, remover ou editar um trecho pequeno não apaga o padrão nas partes que sobraram.
Quando a marca “falha”
Um ponto que a própria Anthropic destacou, e que eu acho essencial pra você não achar que essa tecnologia é infalível, é que em trechos onde só existe uma resposta certa, não tem como o sistema “empurrar” o modelo pra outra escolha sem simplesmente deixar a resposta errada. O exemplo que eles deram foi:
Assim que o modelo escrever “2 + 2 =”, há uma escolha muito clara para o próximo token (se o modelo estiver completando a soma, não há uma resposta tão boa quanto “4”; se estiver falando sobre 1984 de George Orwell, não há uma resposta tão boa quanto “5”).
Ou seja: nesses casos o modelo não tem uma alternativa igualmente boa pra escolher em nome da marca d’água. Forçar uma escolha “menos óbvia” ali quebraria a qualidade da resposta, então o watermarking simplesmente fica de fora e deixa o token mais provável passar.
É justamente por isso que a marca funciona melhor em textos mais longos, com bastante ambiguidade lexical natural (tipo um e-mail, um resumo, um texto criativo), e fica mais fraca ou some completamente em respostas muito curtas ou muito técnicas, onde praticamente cada palavra é “obrigatória”. Um detector de watermark, portanto, não dá uma resposta binária de “é IA” ou “não é IA”. Ele calcula uma probabilidade, baseada em quantos tokens do texto mostraram aquele viés estatístico.
O que uma marca d’água prova (e o que ela NÃO prova)
Aqui mora uma confusão gigante que já apareceu bastante na cobertura sobre o assunto, e que eu acho importante deixar bem clara. A Anthropic foi direta ao afirmar: a existência de uma marca no texto não é totalmente conclusiva de que aquele conteúdo foi inteiramente gerado pela IA, só de que ele foi processado por um modelo Claude.
Ou seja, imagina esses cenários:
- Você escreve um parágrafo inteiro sozinho e só pede pro Claude revisar a gramática. O texto final vai carregar a marca d’água.
- Você pede pro Claude traduzir um texto seu pra outro idioma. Como toda palavra da tradução foi escolhida pelo modelo, o texto traduzido carrega a marca, mesmo que a ideia original tenha sido 100% sua.
- Um estudante multilíngue usa o Claude só pra deixar seu inglês mais claro. O texto carrega a marca.
- Alguém pede pra reorganizar um parágrafo já pronto. O texto carrega a marca.
Todos esses casos, completamente diferentes em termos de “quanto de trabalho humano” existe ali, deixam exatamente a mesma marca. É por isso que uma coluna publicada na Forbes resumiu bem o problema que a marca prova que o Claude foi usado, não quem escreveu o quê. Tratar assistência de IA, geração de IA e desonestidade acadêmica como sinônimos é um erro, e a marca, sozinha, não resolve essa confusão. Ela só entrega um resultado que parece científico, mas que pode esconder o mesmo problema de sempre.
E o inverso também é verdade: a ausência de marca detectada não significa que o conteúdo não foi gerado ou processado por IA. Um print de uma imagem gerada, uma conversão de formato, ou simplesmente passar o texto por outro modelo de outra empresa que não tenha esses sistema (ou que tenha o seu próprio) pode “limpar” a marca.
Imagino que será o modo que mais será usado de agora em diante: você gera o texto no Claude, mas passa ele pelo GPT, Gemini ou Grok, pedindo pra reescrevê-lo mantendo a mesma ideia central e exemplo, mas usando sinônimos. Isso já seria o bastante pra inutilizar parcial ou completamente aquela validação estatística.
Como era de se esperar, a notícia gerou bastante discussão. Segundo uma reportagem do TechCrunch, uma parte considerável da irritação vem justamente de gente preocupada em ser “pega” usando IA pra tarefas que, tecnicamente, deveriam ser feitas (ou pelo menos assinadas) por humanos, como estudantes que pedem pra reorganizar um parágrafo, jornalistas que colam resumos gerados por IA direto no texto final ou redatores que pedem sinônimos pra destravar um bloqueio criativo.
Também teve gente notando uma ironia interessante. As empresas de IA que treinaram seus modelos usando montanhas de conteúdo produzido por humanos (muita coisa sem consentimento explícito), e agora estão aplicando uma camada de rastreabilidade sobre o que os humanos estão gerando com elas.
Conclusão
Honestamente, apesar do incômodo natural, acho que era apenas uma questão de tempo até que isso chegasse. Pra imagens e vídeos acaba sendo algo positivo e desejável, mas pra textos, ainda fico na dúvida da real utilidade. De qualquer forma, é bom saber que agora essa impressão digital estatística existe, e entender como essa marca é criada ajuda a entender tanto o que ela realmente prova quanto os limites (bem reais) do que ela promete resolver.
Bons estudos!