Loss Function (Função de Perda): como a IA aprende com os próprios erros
Publicado em
Você já ouviu falar da famosa “Loss Function” (ou Função de Perda)? Se você leu meu post passado sobre Logits, prepare-se pra dar o próximo passo na nossa jornada técnica e entender como os LLMs realmente aprendem por baixo dos panos durante o treinamento.
O único objetivo de uma rede neural
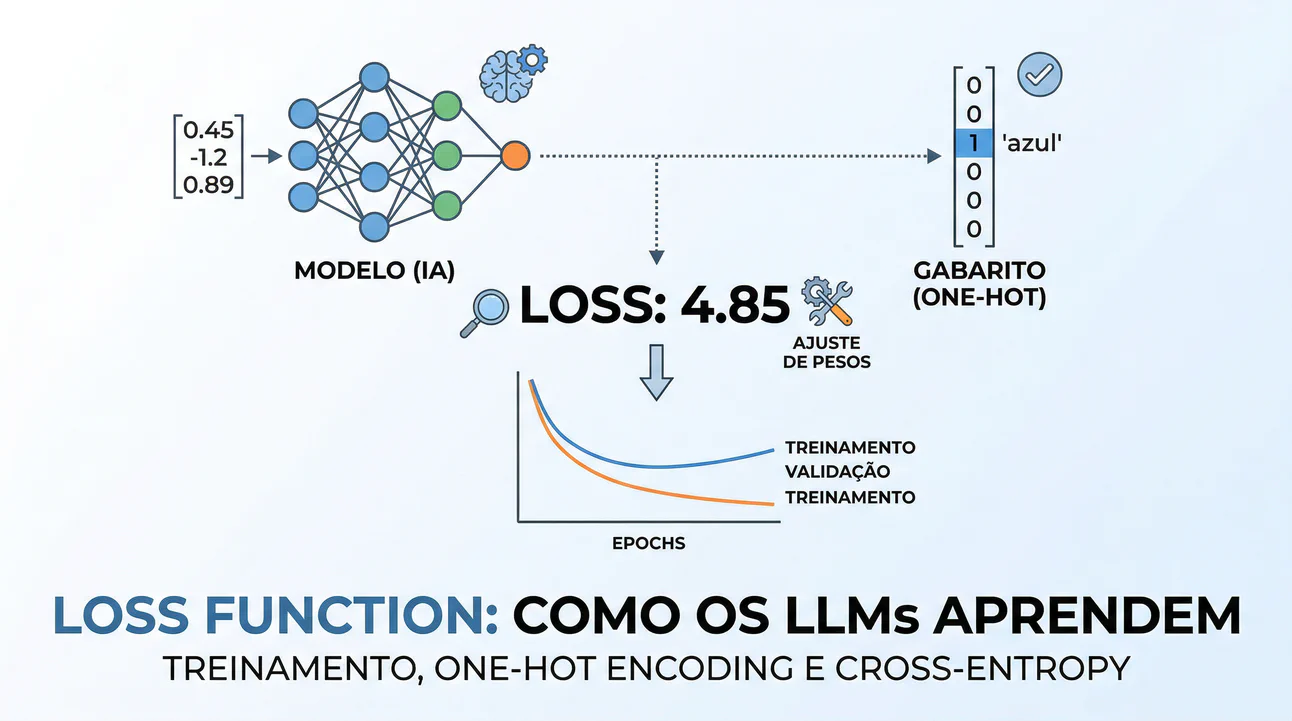
De forma bem direta, a função de perda é uma fórmula matemática que atua como o grande revisor de ENEM pra uma IA. Ela avalia o resultado que o modelo gerou, compara com o gabarito real e cospe um número que diz o quão errada a rede neural está. Durante a fase de treinamento, o único objetivo de vida do modelo é tentar reduzir esse número ao máximo.
Mas pra entender como ela faz isso, precisamos olhar pra dentro de uma rede neural. Pense na rede (um LLM como o GPT, Gemini ou Claude, por exemplo) como um grafo gigantesco, composto por nós (os neurônios) e arestas (as conexões). A mágica acontece na forma como os famosos parâmetros da rede (que se dividem em pesos e vieses ) se distribuem aí dentro.
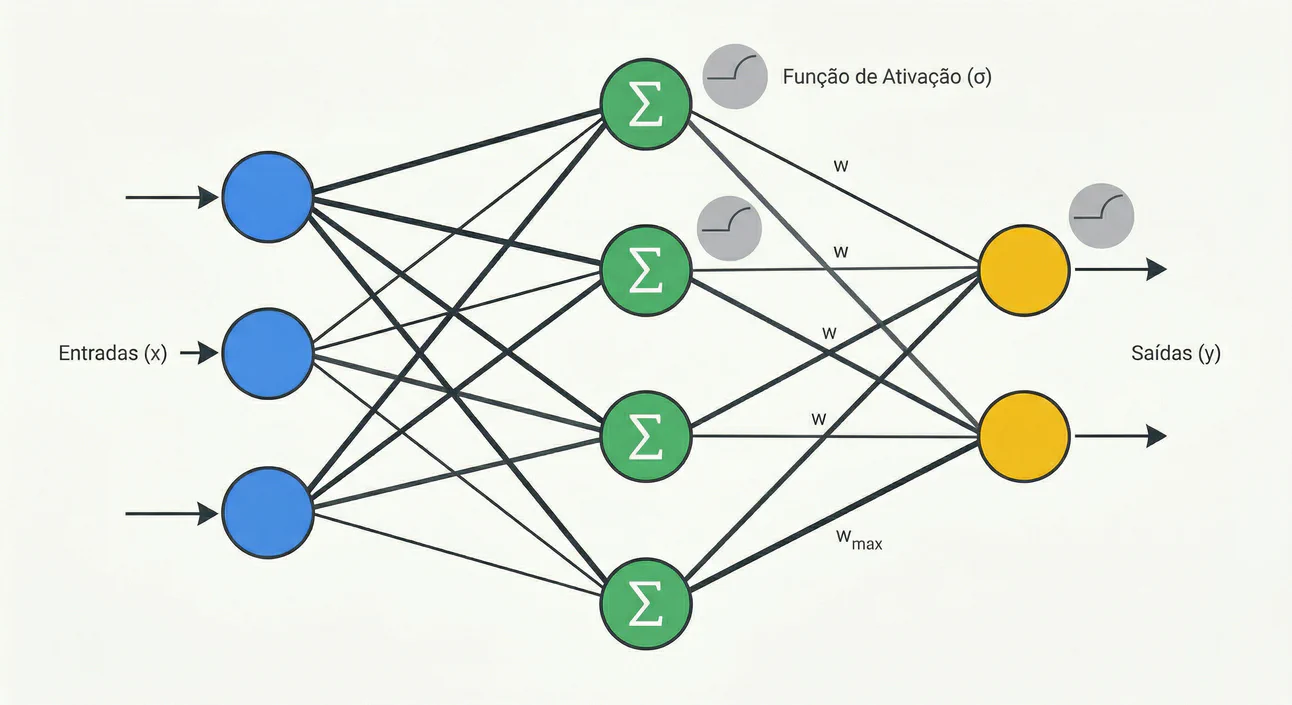
E claro, os dados de entrada viajam pelas arestas. Mas antes de avançar, o que exatamente é esse “dado de entrada”? Uma rede neural não sabe ler texto em português ou inglês. Lembrando do artigo de Logits, se você escreve a palavra “céu”, o modelo primeiro transforma esse token em uma lista extensa de números (um vetor matemático chamado Embedding). Então, quando falamos de “dado de entrada”, imagine um vetor de números decimais (como [0.45, -1.2, 0.89, …]) entrando pela porta da frente da primeira camada da rede. São esses números que viajam pelas arestas.
E aí, cada aresta carrega um multiplicador chamado peso (weight). Quando o dado de entrada passa por ali, ele é multiplicado por esse peso. Quando a IA está aprendendo e corrigindo os erros, são exatamente os pesos dessas arestas, esses multiplicadores, que vão sendo alterados. Já os nós (neurônios) são as centrais de processamento: eles recebem todos os valores multiplicados que vieram das arestas, somam tudo, somam uma constante (o viés, ou bias) e, por fim, aplicam uma fórmula matemática (a Função de Ativação). É o resultado dessa fórmula no nó que gera o novo valor a ser disparado pra próxima camada da rede.
No início do treinamento, esses bilhões de valores estão ajustados de forma totalmente aleatória. É como um aluno fazendo uma prova onde ele chuta todas as respostas sem nem ler as perguntas. Obviamente, a Loss Function pega essa resposta aleatória, compara com o gabarito perfeito e dá um “puxão de orelha” matemático na rede, resultando em uma Loss altíssima.
E aqui entra a engenharia pesada. O modelo não “pensa” em escrever textos bonitos. A única motivação existencial dele é minimizar esse número de erro, essa Loss. Pra baixar a Loss no próximo chute, a rede precisa descobrir quais daqueles bilhões de pesos contribuíram pro erro e em que direção ajustá-los pra tentar chegar em respostas melhores de acordo com o gabarito do treinamento.
Em modelos profundos (Deep Learning) com centenas de camadas, esse processo é gigantesco. A Loss lá na ponta final precisa impactar até a primeira camada da rede. O treinamento de um modelo de IA é basicamente uma repetição ad eternum desse ciclo de “chutar, calcular a Loss, propagar o erro de volta e ajustar os pesos”, transformando palpites aleatórios em redes neurais bem treinadas.
O Gabarito e o “One-Hot Encoding”
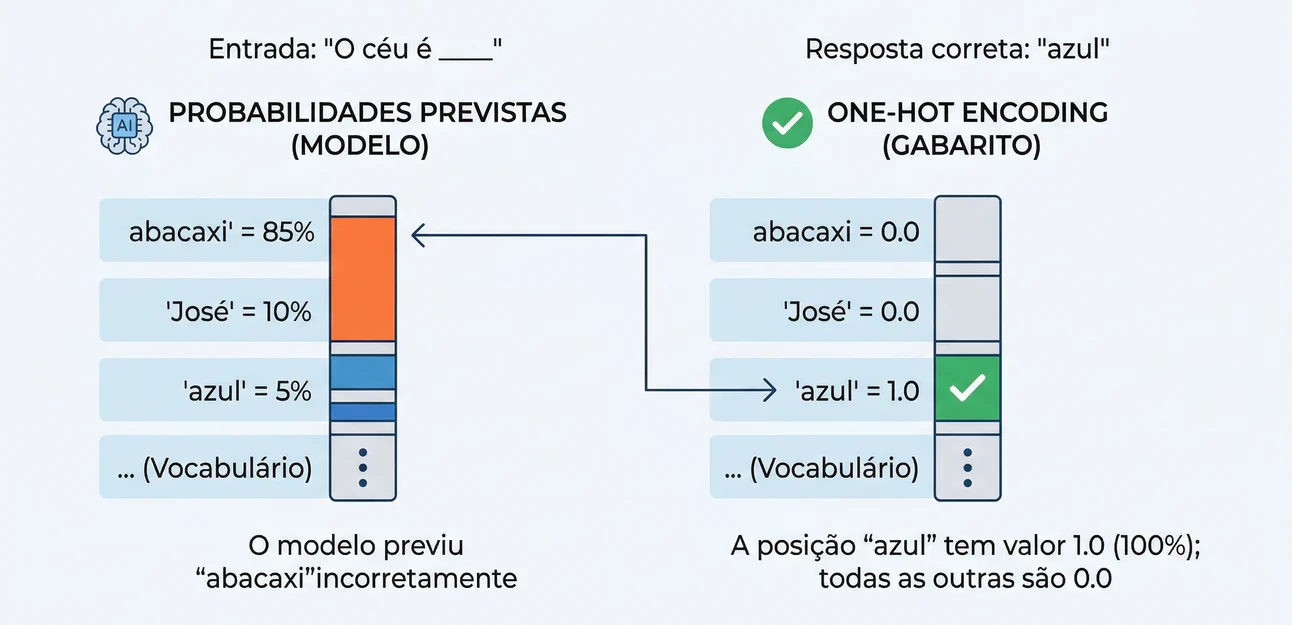
Voltando pro exemplo que eu dei no artigo sobre Logits de tentar completar a frase: “O céu é ____”. Imagina que estamos treinando um LLM do zero. Como vimos antes, o modelo processa o texto e a última camada cospe os logits, que após a função Softmax viram probabilidades de 0 a 100%. Suponha que o nosso gabarito pra completar essa frase seja o token “azul”, mas como o nosso modelo acabou de nascer e os pesos dele ainda são aleatórios, ele gerou a seguinte probabilidade pro próximo token:
"O céu é ____"
- “abacaxi” = 85%
- “José” = 10%
- “azul” = 5%
- …
Seguindo essas probabilidades, a resposta que ele deu foi: “O céu é abacaxi”. Errou feio, errou rude. Mas como a gente traduz esse “gabarito” pra matemática? Nós usamos uma técnica chamada One-Hot Encoding. Basicamente, nós criamos um vetor do exato mesmo tamanho do vocabulário (ex: 100.000 palavras/tokens), onde a posição da palavra correta (“azul”) recebe o valor 1.0 (100%) e absolutamente todas as outras recebem 0.0. Esse é o mundo ideal que a IA precisa tentar imitar.
A Matemática da Cross-Entropy
É exatamente aqui que entra a Loss Function. Pra modelos de linguagem, a função de perda padrão na indústria é a Cross-Entropy Loss (Perda de Entropia Cruzada), mas existem muitas outras funções de perda.
Só por curiosidade: “Entropia” é um conceito da Teoria da Informação que mede a incerteza ou a surpresa de um evento, e “Cruzada” (Cross) significa que estamos medindo a diferença (cruzando) entre duas distribuições de probabilidade: a do modelo e a do mundo real (gabarito). Por isso essa função de perda tem esse nome.
A matemática por trás dela pega a distribuição de probabilidades que o modelo inventou e compara com o gabarito em formato de um “1” e vários “0"s do vetor One-Hot. Vamos dar uma olhada na fórmula matemática dela. Não entre em pânico:
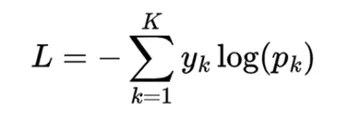
Onde:
- K é o tamanho do nosso vocabulário (ex: 100.000 tokens)
- y(k) é o valor real do gabarito (que é 1 pra palavra certa e 0 pra todo o resto, graças ao One-Hot Encoding)
- p(k) é a probabilidade (entre 0 e 1) que o modelo previu para aquele token
O grande truque dessa fórmula é o somatório (∑). Como o nosso gabarito y(k) é igual a zero pra 99.999 palavras do vocabulário, qualquer coisa multiplicada por zero é zero. A conta inteira “colapsa” e passa a ignorar todas as palavras erradas. A fórmula vai focar só na probabilidade que o modelo deu pra a palavra certa. Matematicamente, isso é feito usando o logaritmo, e o comportamento dele aqui é perfeito pra punir a IA. Funciona assim:
- Se o modelo tem muita certeza e previu 0.99 (99%) de chance pra palavra correta, o logaritmo de 0.99 é um número muito próximo de zero. A Loss fica baixíssima. O modelo acertou e não precisa ser corrigido.
- Mas se o modelo errou muito rude e previu uma probabilidade de só 0.05 (5%) pra palavra certa, o logaritmo de 0.05 é um número negativo gigante.
E é por isso que tem aquele sinal de menos (−) na frente da fórmula inteira. Ele pega esse número negativo enorme e inverte o resultado pra um número positivo enorme. O resultado dessa conta é um valor escalar (digamos, um belo 4.85, que é enorme pra essa magnitude). Esse é o valor final da nossa Loss: um “puxão de orelha” matemático gigantesco dizendo que a IA precisa ajustar seus pesos urgente, pois deu uma probabilidade minúscula pra resposta correta.
Batches e Backpropagation
Na prática, a IA não calcula a Loss de uma frase e já atualiza tudo. Isso seria muito lento e instável. Ela processa um Batch (Lote) com milhares de frases ao mesmo tempo, e a Loss final é a média do erro de todos esses exemplos.
Com esse número médio em mãos (o nosso 4.85), um algoritmo otimizador (geralmente o AdamW) usa uma técnica brilhante chamada Backpropagation (Retropropagação) pra calcular o Gradiente Descendente (que explicarei melhor em outro artigo). Ele volta de trás pra frente pela rede neural inteira, descobrindo o quanto cada um dos bilhões de parâmetros contribuiu pra aquele erro. Em seguida, ele ajusta esses pesos só um pouquinho (usando a “Taxa de Aprendizado” pra definir quanto é esse “pouquinho”), na direção exata que faria essa Loss diminuir da próxima vez.
A IA repete esse processo de chutar, errar, calcular a loss em lote e ajustar os pesos bilhões de vezes, até que ela pare de prever “abacaxi” e comece a dar 99% de chance pro token “azul”, a resposta certa.
O que o desenvolvedor realmente vê
No dia a dia, quem treina IA não fica olhando números soltos no terminal. A gente acompanha exatamente o valor da Loss (o ideal é que vá caindo a cada rodada de treinamento), e uma curva de como ela está evoluindo com os passos de treinamento da rede neural.
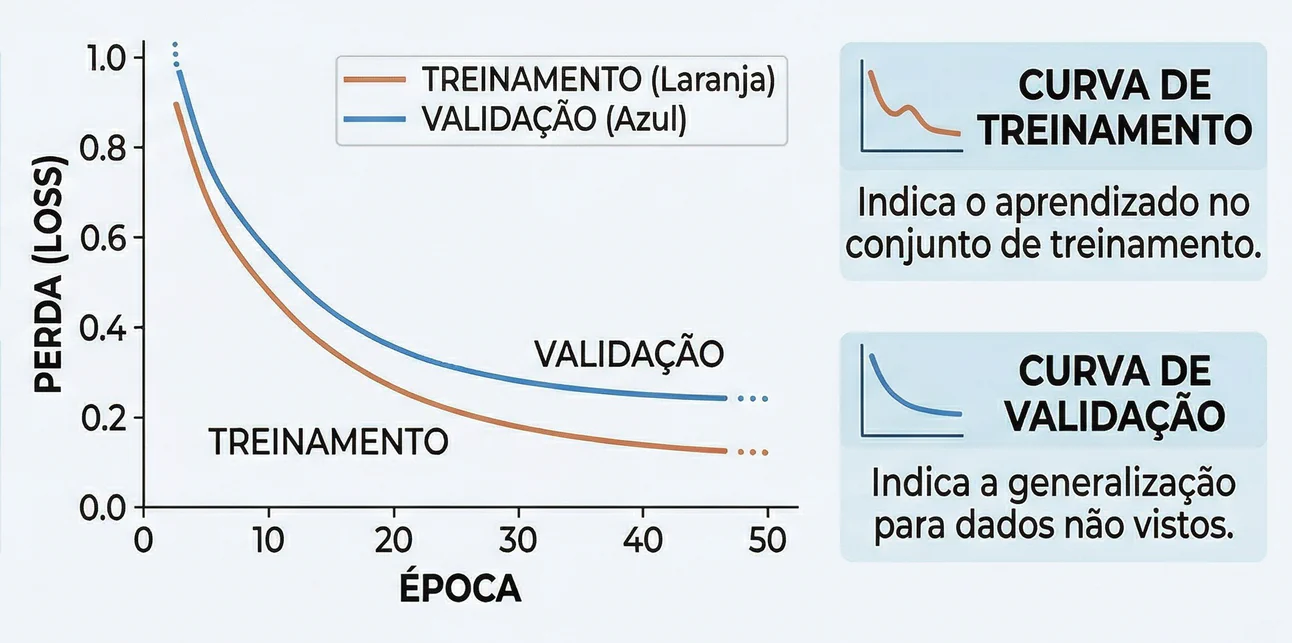
E a ideia é monitorar duas linhas principais: a Training Loss (o erro nos dados que a IA está estudando) e a Validation Loss (o erro em uma prova surpresa com dados que ela nunca viu). Se a Training Loss continua caindo, mas a Validation Loss começa a subir, já soa o alarme: temos um Overfitting, ou seja, a IA parou de entender a linguagem e começou a apenas “decorar” o conjunto de treinamento. Isso significa que, provavelmente, ela não vai saber fazer bem outras provas surpresa do mundo real. Em linguagem de IA, dizemos que esse seria um modelo que “generaliza” mal.
Colocando a Mão no Código (PyTorch)
Se você quer brincar de código com o PyTorch, dá pra ver a implementação disso:
import torch
import torch.nn as nn

# Vamos simular um vocabulário de 4 palavras: [azul, lindo, abacaxi, Maria]
# O modelo processou a frase e gerou esses LOGITS brutos (sem Softmax ainda)
# Notem que o índice 2 ('abacaxi') recebeu o maior logit (5.3)
logits = torch.tensor([[-1.2, 0.5, 5.3, -0.1]])

# O nosso gabarito (target) é o índice 0 ('azul') - o PyTorch faz o One-Hot internamente!
target = torch.tensor([0])

# Instanciando a função de perda
loss_fn = nn.CrossEntropyLoss()

# Calculando o erro!
loss = loss_fn(logits, target)

print(f"Valor da Loss: {loss.item():.4f}")
Um detalhe super legal de engenharia de software aqui: na prática, o método nn.CrossEntropyLoss() do PyTorch já aplica o Softmax junto com o cálculo do logaritmo por baixo dos panos. Fazer as duas operações matemáticas juntas é muito mais rápido e numericamente estável do que fazer o Softmax antes e calcular a perda depois! Por isso, passamos direto os logits brutos pra função.
E é mais ou menos isso! :) Entender como os Logits se conectam com a Loss Function e como ela guia os gradientes é entender o verdadeiro motor de aprendizagem de qualquer modelo de IA moderno. Saber como a salsicha é feita muda o jogo.
Bons estudos!